虚拟媒体库
虚拟媒体库不绑定任何存储目录,靠外部 API 榜单或系统自动统计组合出一个新视角的媒体墙。
面向想快速上线「大家在看」这类合集、又不想再配一遍文件夹和刮削的管理员。
能做什么
- 接一个外部 HTTP 榜单接口,用 JSONPath 抽出条目数组与 TMDB ID,自动生成一个媒体库。
- 在线「发送测试」验证接口通不通、抽取规则对不对,直接看原始响应。
- 用「大家在看」「节点缓存」两种智能库,零配置。
- 与真实库在同一侧边栏混排、混合拖拽排序,用户端看到的是一堵完整的墙。
界面与操作
两种类型
| 类型 | 内容来源 |
|---|---|
| API 拉取 | 通用 HTTP API 源,一个库可以挂多个源 |
| 智能库 | 系统自动计算,界面上注明「智能库内容由系统自动计算,无需手动配置来源」 |
智能库有两种:
| 名称 | 配置 |
|---|---|
| 大家在看 | 配置 JSON:time_window_days 默认 30、max_items 默认 100 |
| 节点缓存 | 绑定一个节点,展示该节点当前缓存的内容 |
API 源字段
一个 API 源的完整配置如下,密钥不要写死在 URL 里,用变量 Secrets 引用:
| 字段 | 说明 |
|---|---|
| 来源名称 | 这个源叫什么 |
| HTTP 方法 | GET / POST / PUT / PATCH |
| 请求 URL | 支持 {{变量}} 占位 |
| Headers | 名 / 值,值支持 {{变量}} |
| 请求体 | 非 GET 方法时才显示 |
| 认证方式 | NONE / BEARER / BASIC / API_KEY_HEADER / API_KEY_QUERY,加对应的认证参数 |
| 变量 Secrets | 键值对,在 URL / Headers / Body 中用 {{名称}} 引用 |
| Items 数组 JSONPath | 默认 $.movies[*] |
| TMDB ID JSONPath | 默认 $.ids.tmdb |
| 媒体类型 | 电影 / 剧集 |
| 刷新间隔(分钟) | 默认 60,最小 1 |
| 启用 / 排序 | 控制该源是否参与刷新,以及顺序 |
卡片上显示「每 N 分钟」,以及上次抓取时间或错误信息。
测试与刷新
配好之后先点「发送测试」:它会真的发一次请求,返回 HTTP 状态、抽取到的条目数量、TMDB ID 列表与可展开的原始响应,方便你确认 JSONPath 写对了没有。
正式刷新分两条路径。手动刷新有两档——增量刷新与全覆盖刷新;自动刷新由定时任务 virtual-library.api-refresh 每 180 秒拉取一次到期的源,到期与否按各源自己的刷新间隔算。
关键规则
- 类型只在新建时可选,建好后编辑不能改。
- 虚拟库靠 TMDB ID 与中央媒体库求交集,只展示已经存在的内容——外部榜单里你没有的片子不会凭空出现在墙上。
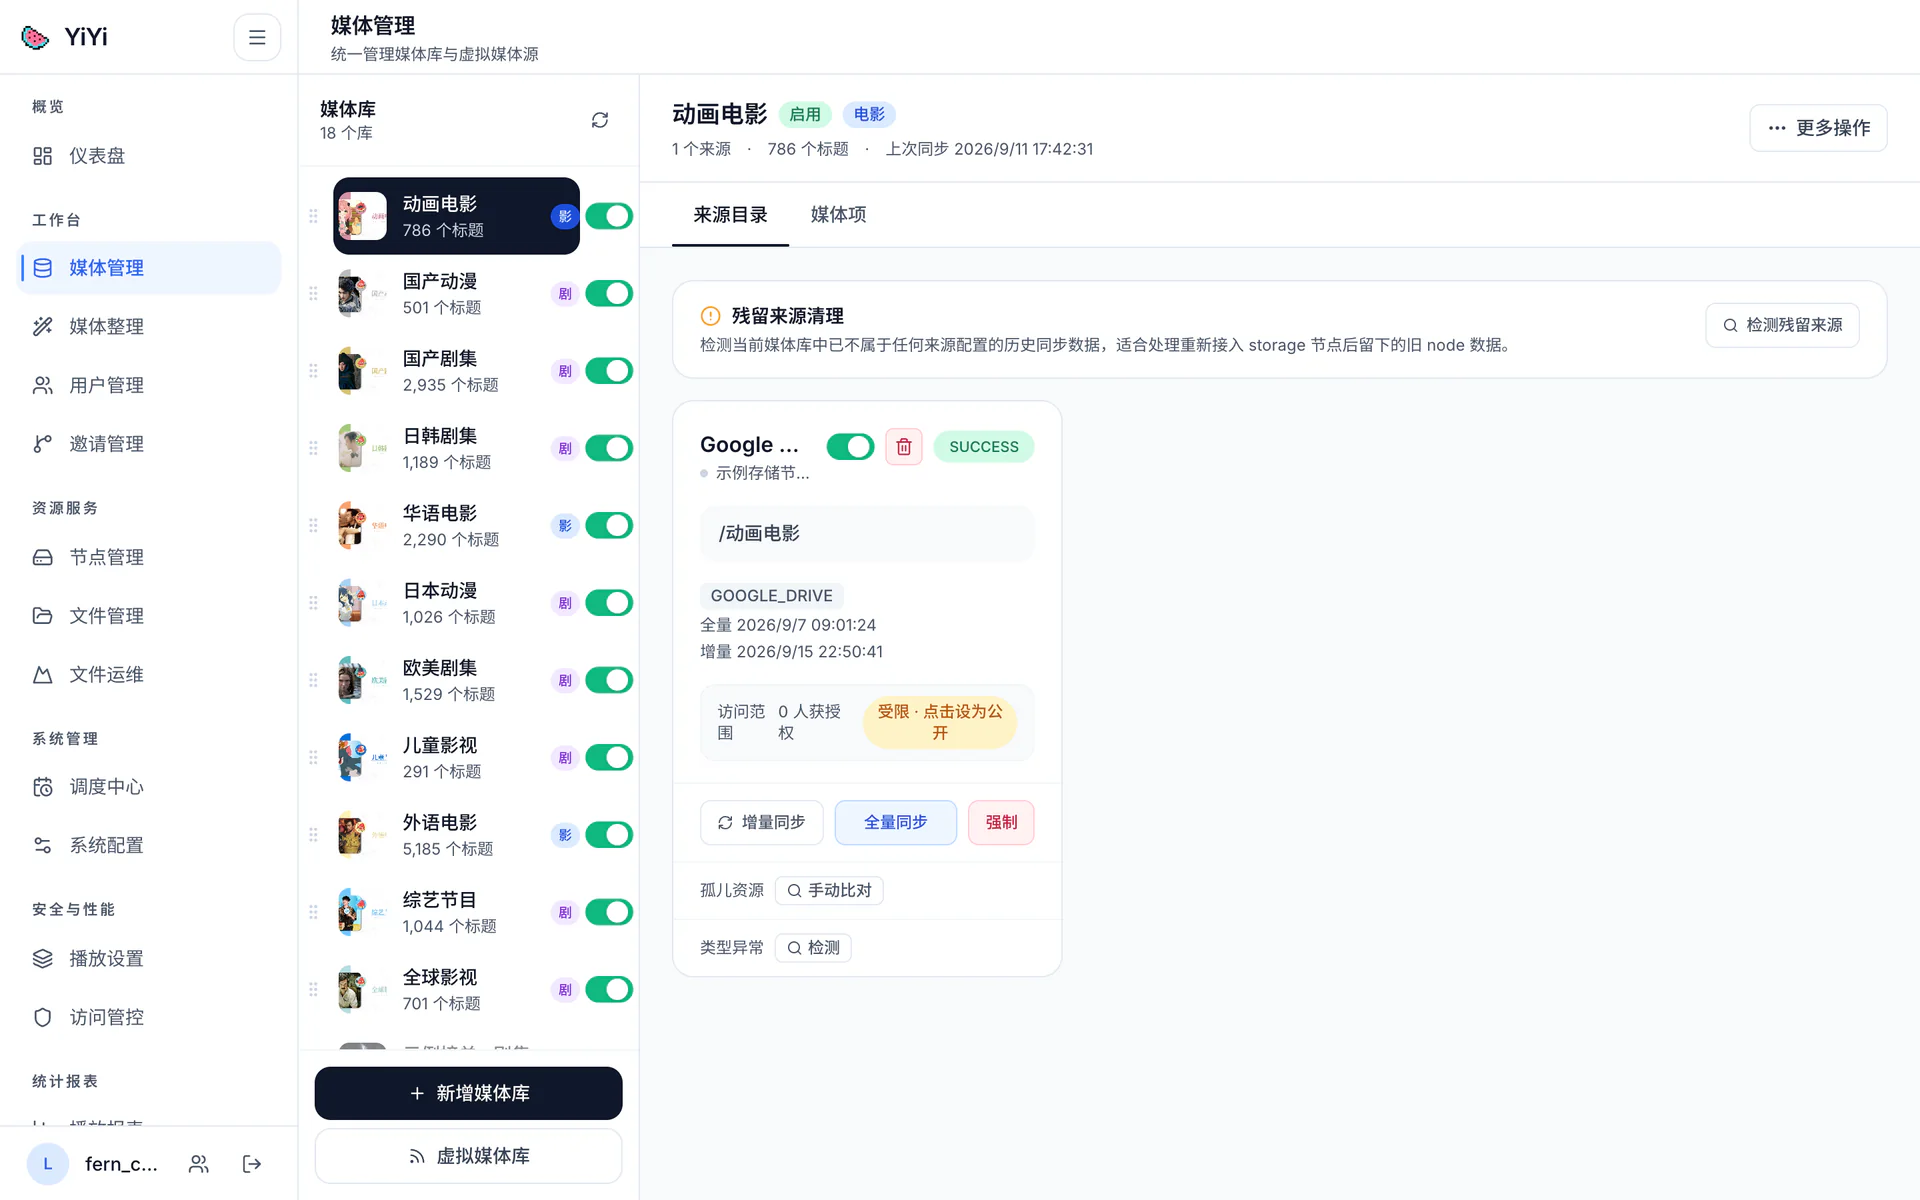
- 与真实库的差异要记清:没有来源目录、没有同步 Dry-run、没有孤儿 / 残留 / 类型异常三项体检、没有条目管理页签。
- 虚拟库同样受媒体源访问控制过滤。
- 想改条目本身的标题、封面、简介,得回到媒体管理里对真实条目做元数据覆盖,虚拟库不提供这层编辑。